Pourquoi PostgreSQL est en train de dévorer l'écosystème des bases de données
Pourquoi multiplier les bases de données quand un seul moteur peut tout faire ? Découvrez comment PostgreSQL simplifie les architectures modernes et remplace les bases spécialisées grâce à son écosystème d'extensions.
Pendant plus d'une décennie, le dogme de la persistance polyglotte a imposé une règle stricte aux équipes d'ingénierie : chaque besoin nécessitait sa propre base de données. On accumulait du MySQL pour le relationnel, du MongoDB pour les documents, du Redis pour le cache et du ElasticSearch pour la recherche textuelle. Cette complexité opérationnelle, coûteuse en maintenance et en compétences, est aujourd'hui remise en question par le retour en force d'un acteur historique : PostgreSQL.
Créé il y a près de quarante ans, ce système de gestion de base de données relationnelle connaît une seconde jeunesse spectaculaire. PostgreSQL est devenu le choix par défaut pour une majorité de projets récents. Sa robustesse légendaire et sa conformité aux standards se combinent désormais avec des capacités modulaires qui viennent chasser directement sur les terres des bases spécialisées.
Ce mouvement d'unification s'accélère avec l'explosion des besoins liés à l'intelligence artificielle. Plutôt que d'adopter de nouvelles bases vectorielles dédiées pour stocker des embeddings, les entreprises se tournent massivement vers PostgreSQL. Cette capacité à absorber de nouveaux cas d'usage sans détruire l'existant transforme en profondeur la manière dont on conçoit les architectures logicielles modernes.
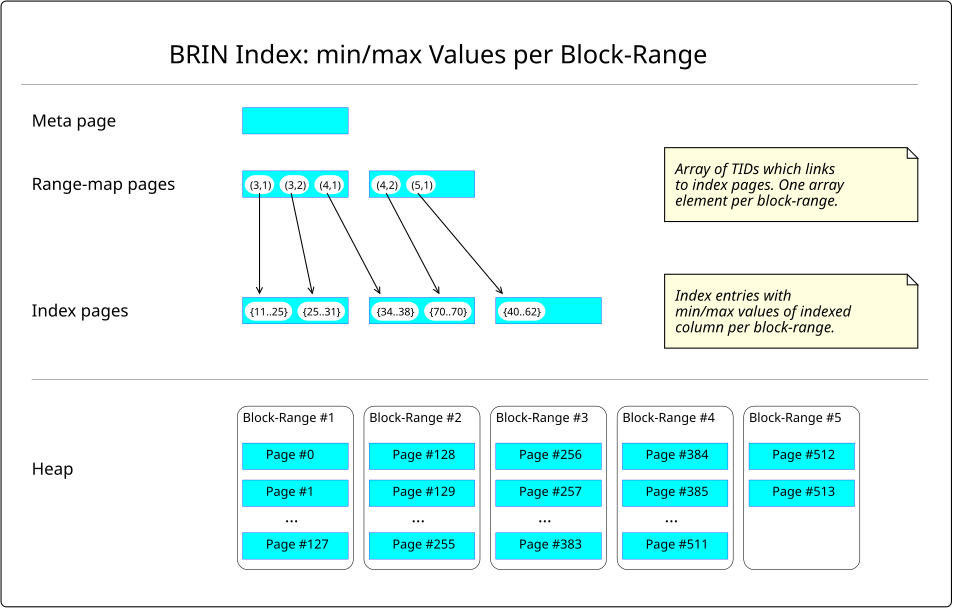
Par exemple, un index BRIN permet de retrouver rapidement une information dans une très grande base de données sans avoir à parcourir chaque ligne. Il divise les données en plusieurs groupes de pages et conserve pour chacun des valeurs résumées, comme le minimum et le maximum. Ainsi, si la recherche ne peut pas se trouver dans un groupe, PostgreSQL peut directement l’ignorer et gagner du temps.
Comment ça marche : la puissance de l'architecture d'extensions
Au cœur du succès de PostgreSQL se trouve une conception modulaire pensée dès l'origine. Contrairement à d'autres moteurs relationnels dont le cœur reste rigide, PostgreSQL intègre un système d'extensions qui permet d'ajouter de nouveaux types de données, des index spécifiques et des fonctions personnalisées sans altérer la stabilité du noyau central.
L'exemple le plus frappant est pgvector, une extension devenue incontournable dans les projets d'intelligence artificielle. Elle permet de stocker des vecteurs et d'exécuter des recherches de similarité directement en SQL. Au lieu de déployer et de maintenir une base vectorielle dédiée, les équipes conservent leur infrastructure existante pour alimenter leurs applications d'IA.
Cette même philosophie s'applique à d'autres domaines spécialisés. Avec PostGIS, PostgreSQL est depuis longtemps la référence absolue pour le traitement des données géospatiales. Grâce à TimescaleDB, le moteur gère les séries temporelles et les métriques IoT avec des performances très élevées. L'écosystème propose ainsi des réponses ciblées à une multitude de besoins métiers.
En unifiant ces usages au sein d'un même moteur, PostgreSQL élimine la contrainte de synchronisation entre plusieurs bases distantes. Les développeurs n'ont plus besoin de concevoir des pipelines de données complexes et fragiles uniquement pour transférer des informations d'un outil à un autre. Tout reste centralisé, sécurisé et immédiatement requêtable.
Faut-il s'inquiéter : les limites du couteau suisse
Centraliser l'ensemble de ses données dans un moteur unique comme PostgreSQL présente des avantages évidents, mais cette approche comporte aussi des risques d'architecture. En confiant le stockage relationnel, la recherche textuelle, les métriques et les vecteurs d'IA au même cluster, vous créez un point d'infaillibilité unique. Une requête vectorielle mal optimisée ou gourmande en mémoire peut impacter directement les transactions critiques de votre application.
Il faut également mesurer la réalité des besoins à très grande échelle. Si les extensions permettent de couvrir la majorité des cas d'usage pour des PME ou des entreprises en croissance, elles ne remplacent pas totalement les moteurs spécialisés sur des volumes gigantesques. Une infrastructure qui doit gérer des dizaines de millions d'événements par seconde aura toujours intérêt à isoler ses séries temporelles ou ses index de recherche.
L'autre limite concerne la gestion de la mémoire et des ressources matérielles. Chaque extension impose ses propres contraintes d'optimisation au moteur. Régler finement un serveur PostgreSQL pour traiter efficacement à la fois des requêtes OLTP légères et du calcul lourd sur des vecteurs nécessite des compétences pointues d'administration système que toutes les équipes ne possèdent pas en interne.
Pour autant, il ne s'agit pas d'éviter cette stratégie. Pour l'écrasante majorité des projets, la simplification de la stack technique l'emporte largement sur ces contraintes. La véritable erreur serait de rejeter PostgreSQL par dogme au profit d'une constellation de bases spécialisées dont la maintenance deviendra rapidement un cauchemar opérationnel.
Que faire concrètement : rationaliser sa stack sans dogmatisme
La première étape consiste à réaliser un audit complet de votre infrastructure de données. Identifiez l'ensemble des bases de données déployées dans vos environnements et mesurez le coût opérationnel réel de leur maintenance. Dans de nombreux cas, vous découvrirez que des bases NoSQL ou des moteurs secondaires sont sous-exploités et pourraient être avantageusement remplacés par une instance PostgreSQL mieux configurée.
Pour vos nouveaux projets, faites de PostgreSQL votre choix par défaut. Avant d'ajouter un service tiers pour gérer des vecteurs d'IA, du cache ou de la recherche textuelle, testez les capacités natives du moteur et de ses extensions. Cette approche permet de valider vos hypothèses produits rapidement, sans ajouter de complexité inutile à votre architecture logicielle.
Pensez toutefois à isoler les charges de travail lourdes pour protéger vos transactions critiques. Si vos besoins en calcul vectoriel ou en analyse de données deviennent conséquents, séparez physiquement les instances. Vous pouvez utiliser la réplication logique pour alimenter un serveur PostgreSQL dédié aux requêtes analytiques sans risquer de ralentir la base principale.
Enfin, investissez dans la formation de vos équipes d'ingénierie à l'administration fine de PostgreSQL. Maîtriser le réglage des index, la gestion du pool de connexions et le suivi des métriques apporte un retour sur investissement bien supérieur à la gestion de plusieurs technologies hétérogènes. La simplicité opérationnelle reste le meilleur garant de la fiabilité de vos systèmes sur le long terme.
Sources :
- PostgreSQL Global Development Group : https://www.postgresql.org (Documentation officielle du moteur et des fonctionnalités de réplication).
- pgvector Open Source Project : https://github.com/pgvector/pgvector (Spécifications de l'extension de recherche vectorielle).
Commentaires ()